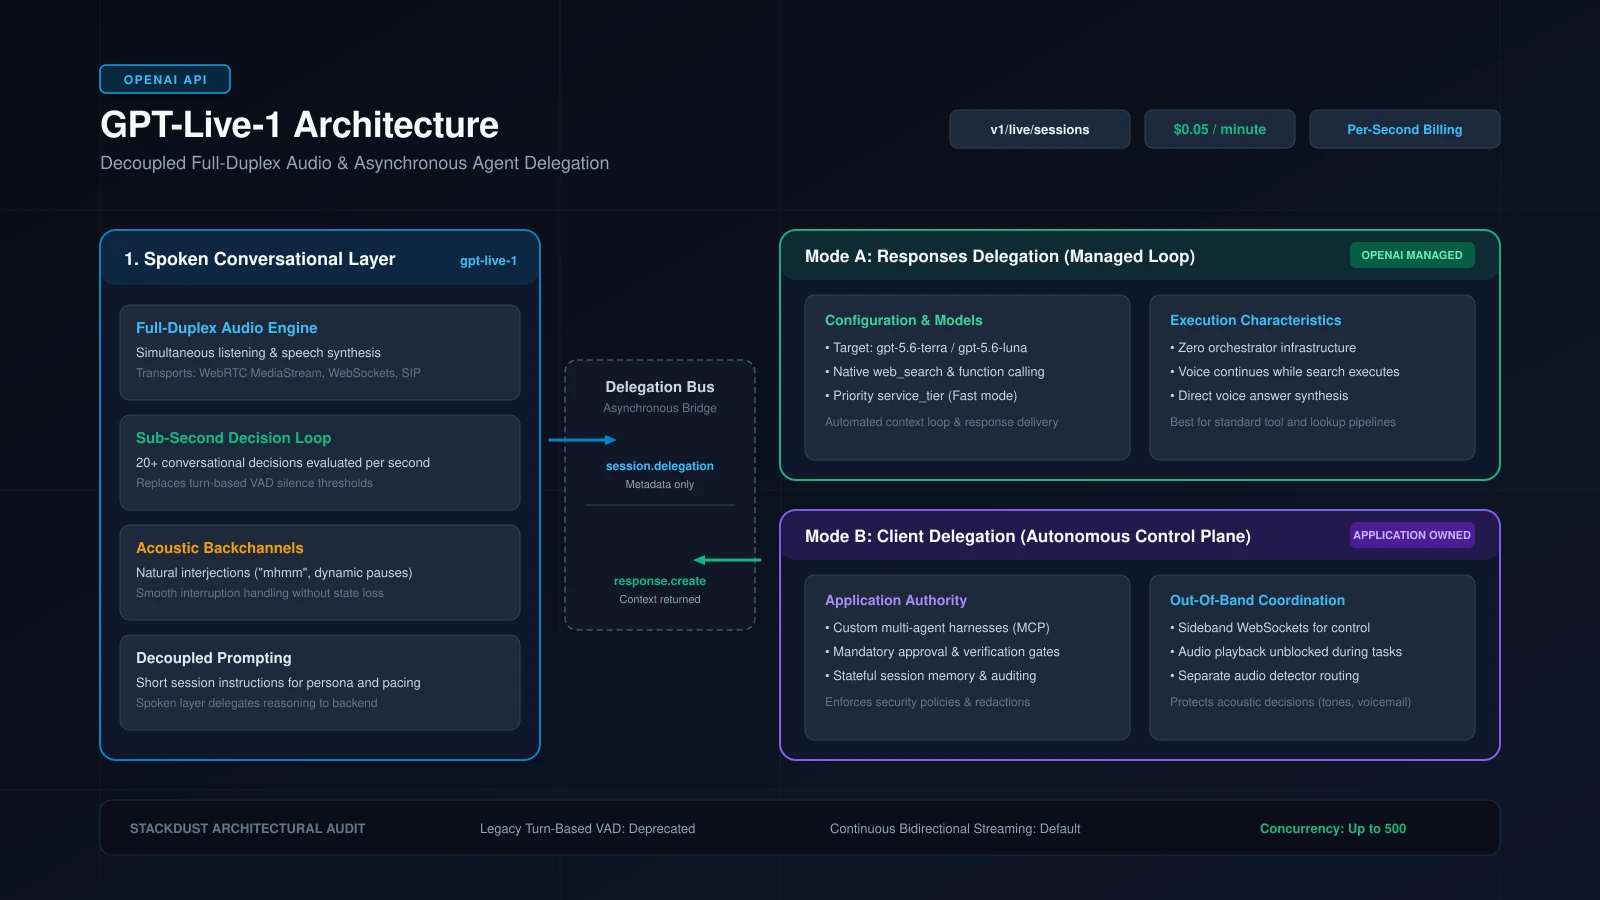
أوبن إيه آي تطلق واجهة GPT-Live-1: صوت ثنائي الاتجاه بالكامل وتفويض غير متزامن للوكلاء
على مدى عامين كاملين، عاشت تطبيقات الذكاء الاصطناعي الصوتية تحت وطأة مساومة هندسية محرجة: أنظمة تبادل الأدوار القائمة على كشف النشاط الصوتي (Voice Activity Detection - VAD). كان العميل يرسل الصوت إلى مخزن مؤقت، وينتظر توقف المستخدم عن الحديث، ثم ينتظر مهلة صمت تتراوح بين 300 و800 مللي ثانية للتأكد من نهاية الدور، ثم ينفذ الاستدلال على نموذج أحادي ضخم، ليعيد بعد ذلك بث الإجابة. وإذا قاطع المستخدم النموذج أثناء حديثه أو قال كلمة تأكيد عابرة مثل “نعم”، كان النظام إما يتجاهل المقاطعة بخشونة، أو يقطع السياق بالكامل بصورة مربكة.
أطلقت أوبن إيه آي رسمياً اليوم واجهة برمجة التطبيقات لنموذج GPT-Live-1. يقدم هذا الإصدار نموذجاً متخصصاً ثنائي الاتجاه بالكامل (Full-Duplex)، يُتاح عبر نقطة نهاية برمجية جديدة ومستقلة: v1/live/sessions. وبدلاً من إجبار نموذج واحد على الاستماع والتفكير واستدعاء الأدوات وتوليد النبرة الصوتية في حلقة معالجة متزامنة ومقيدة، يعتمد GPT-Live-1 فصلاً معمارياً جذرياً: واجهة صوتية خفيفة ثنائية الاتجاه تستمع وتتحدث في الوقت نفسه، متصلة بناقل تفويض غير متزامن يسند المهام الحوسبية المعقدة إلى نماذج خلفية مثل GPT-5.6 Terra و GPT-5.6 Luna، ونموذج الاستدلال الفائق GPT-6 Astra، أو إلى منظومات وكلاء خارجية مستقلة.
الشروط التجارية للإصدار مباشرة وصريحة: 0.05 دولار لكل دقيقة من وقت الجلسة النشطة، مع حساب الفاتورة بالثانية دون أي تقريب إلى الدقيقة الكاملة. للمطورين الذين يبنون مراكز دعم هاتفي، أو وكلاء مبيعات صوتيين، أو مساعدين برمجيين سطح مكتب، يعيد هذا الإصدار تشكيل البنية التحتية لبرمجيات الحوار الصوتي في الصميم.
ما حدث
تحدد الإعلانات الرسمية وأدلة المطورين المواصفات الأساسية للإطلاق الجديد:
- المعرف الرسمي للنموذج هو
gpt-live-1، ويُتاح حصرياً عبر نقطة النهايةv1/live/sessions. لا تقبل نقاط النهاية التقليدية مثلv1/chat/completionsأوv1/responsesأو نقطة الوقت الفعلي القديمةv1/realtimeهذا النموذج. - وسائط الإدخال والإخراج محصورة في الصوت والنص فقط. لا يدعم النموذج إدخال الصور أو الفيديو مباشرة على طبقة الصوت، ويجب تمرير أي سياق بصري عبر قنوات التفويض الخلفي.
- تسعير الجلسة محدد بـ 0.05 دولار للدقيقة الواحدة (أي ما يعادل 3.00 دولارات للساعة)، وتُحسب التكلفة بالثانية باستمرار. وتُفوتر العمليات الخلفية، مثل استدعاء الأدوات أو الاستدلال عبر نماذج مثل GPT-5.6 Terra، بصورة منفصلة وبأسعار الرموز القياسية لتلك النماذج.
- حدود الاستخدام (Rate Limits) مقيدة بعدد الجلسات المتزامنة النشطة بدلاً من عدد الرموز لكل دقيقة: تحصل حسابات المستوى الأول (Tier 1) على 25 جلسة متزامنة، والمستوى الثاني على 50، والمستوى الثالث على 200، والمستوى الرابع على 300، بينما يصل المستوى الخامس إلى 500 جلسة متزامنة. الحسابات المجانية غير مشمولة بالخدمة.
- تاريخ المعرفة المسبقة للنموذج ينتهي في 31 يوليو 2025، ويعتمد كلياً على أدوات الاسترجاع والتفويض الخلفي للوصول إلى المعلومات الحديثة وقواعد البيانات الخاصة.
- تدعم الجلسات بروتوكول WebRTC (لمتصفحات الويب وتطبيقات الهواتف)، وWebSockets الأساسية (لربط الخوادم الصوتية)، وWebSockets الجانبية Sideband (للتحكم الإداري واستدعاء الأدوات خلف الكواليس دون اعتراض تدفق الصوت)، إلى جانب الربط المباشر مع شبكات الهواتف عبر بروتوكول SIP بالتعاون مع شركاء مثل Twilio و LiveKit و Telnyx و Daily.
المعمارية ثنائية الاتجاه: القضاء على تأخير كشف الصمت
الابتكار التقني الجوهري في GPT-Live-1 هو المعالجة الصوتية ثنائية الاتجاه بالكامل (Full-Duplex). في الأنظمة التقليدية، يتنقل النظام ميكانيكياً بين حالتي “الاستماع” و”التحدث”. يتطلب ذلك خوارزمية كشف صمت تقرر متى أنهى المتحدث كلمته. وإذا تم ضبط مهلة الصمت عند حد قصير جداً (مثل 200 مللي ثانية)، فإن أي وقفة تفكير طبيعية للمتحدث تتسبب في مقاطعته وإسكاته. أما إذا تم ضبطها عند حد طويل (مثل 700 مللي ثانية)، فإن كل تبادل للأدوار يبدأ بصمت مطبق ومصطنع.
يتخلى GPT-Live-1 عن هذه الآلة المحدودة للحالات. يقوم النموذج ببث الصوت الوارد بالتزامن التام مع توليد دفقات الصوت الصادرة. وتعمل حلقة قرار داخلية على تقييم الإشارات الصوتية واللغوية أكثر من 20 مرة في الثانية الواحدة. هذا التقييم تحت-الثانية يتيح ثلاثة سلوكيات كانت شبه مستحيلة سابقاً:
- معالجة المقاطعات الطبيعية: عندما يتحدث المستخدم أثناء كلام النموذج، يقرر النموذج في غضون عشرات المللي ثوانٍ ما إذا كان الصوت الوارد مجرد ضوضاء محيطة، أو تأكيداً عابراً (“نعم”، “أفهمك”)، أو مقاطعة حقيقية تستهدف تصحيح مسار المحادثة.
- الإشارات الصوتية الارتجاعية (Backchanneling): يستطيع النموذج إطلاق همهمات أو أصوات تفاعلية خفيفة (مثل “همم” أو إيماءات شفهية) أثناء استماعه للمستخدم، مؤكداً استمراره في المتابعة دون الاستيلاء على دور المتحدث.
- التحكم المرن في النبرة والإيقاع: نظراً لعدم تقييد التوليد بانتهاء دور الإدخال، يستطيع النموذج تسريع وتيرته أو إبطائها ديناميكياً وفق توجيهات الأوامر الفورية.
التفويض غير المتزامن: نمط Responses مقابل نمط العميل المستقل
في البنى البرمجية السابقة، بما في ذلك ما رأيناه في حزمة وكلاء كلود أو واجهات الوقت الفعلي التمهيدية، كان استدعاء الأدوات يفرض تجميد التدفق الصوتي بالكامل حتى يكتمل تنفيذ الأداة. وإذا استغرق استدعاء قاعدة البيانات ثلاث ثوانٍ، كان المتصل يسمع صمتاً محرجاً أو يتطلب الأمر حيل تشتيت صوتية مركبة.
يعالج GPT-Live-1 هذا الخلل عبر الفصل المعماري. تدير الواجهة الصوتية الحوار المباشر، بينما تُحال العمليات الثقيلة عبر ناقل أحداث غير متزامن. وتوفر الواجهة نمطين رئيسيين للتفويض:
النمط الأول: تفويض Responses (المُدار عبر أوبن إيه آي)
في هذا التكوين، تتولى أوبن إيه آي إدارة الحلقة الكاملة بين GPT-Live-1 ونموذج استدلال خلفي مُستضاف. يحدد المطور نموذجاً خلفياً (مثل gpt-5.6-terra للمهام المعقدة أو gpt-5.6-luna للمهام السريعة منخفضة التكلفة) ضمن إعدادات الجلسة.
عندما يطرح المستخدم سؤالاً يتطلب بيانات داخلية أو حسابات، يدرك GPT-Live-1 الحاجة للتفويض ويطلق حدث تفويض فوري. توجه البنية التحتية الطلب إلى نموذج Responses المختار، وتمرر سياق المحادثة المطلوب، وتنفذ الأدوات أو عمليات البحث في الويب، ثم تعيد الإجابة الهيكلية إلى GPT-Live-1 ليصيغها صوتياً للمستخدم. وأثناء هذا الوقت، يواصل GPT-Live-1 التفاعل مع المستخدم شفهياً، مؤكداً استلام طلبه بدلاً من الوقوف صامتاً.
النمط الثاني: تفويض العميل (التحكم الكامل للتطبيق)
بالنسبة للتطبيقات المؤسسية، والقطاعات المصرفية والصحية، والأنظمة المبنية على بروتوكولات الوكلاء المستقلة (مثل MCP)، فإن تفويض Responses قد لا يناسب متطلبات حوكمة البيانات الصارمة، إذ لا يمكن تمرير البيانات الحساسة عبر وسطاء غير مدققين. يحل نمط تفويض العميل (Client Delegation) هذه المعضلة بإعادة كامل سلطة التنفيذ لخادم المطور.
في هذا النمط، عندما يصادف GPT-Live-1 طلباً يحتاج لتدخل خارجي، يطلق حدثاً برمجياً باسم session.delegation.created يحمل البيانات الوصفية للمهمة. والأهم أن هذا الحدث لا يحمل تسجيلاً صوتياً خاما، بل يحمل النية المهيكلة فقط، مما يوفر عرض النطاق الترددي. يتولى خادم التطبيق التحقق من الأذونات، وتطبيق سياسات الأمان، وتنفيذ استعلامات قواعد البيانات، وتدقيق النتائج، ثم يحقن النتيجة المؤكدة مجدداً في الجلسة باستخدام response.item.create و response.create.
مقارنة معمارية بين نمطي التفويض
يوضح الجدول التالي الفروق الهندسية والتشغيلية بين النمطين:
مقارنة أنماط تفويض GPT-Live-1
| البعد المعماري | تفويض Responses (المُدار) | تفويض العميل (المستقل) |
|---|---|---|
| سلطة التنفيذ | بنية أوبن إيه آي السحابية | خادم المطور المستقل |
| النماذج المستهدفة | نماذج محددة من أوبن إيه آي (GPT-5.6) | أي نموذج خاص أو منظومة وكلاء داخلية |
| التحكم بالسياق | يديره GPT-Live تلقائياً | التطبيق يحدد التاريخ والذاكرة بدقة |
| تنفيذ الأدوات | عبر حلقة أدوات أوبن إيه آي المدمجة | خادم التطبيق ينفذ الأدوات بنفسه مباشرة |
| حماية وتنقية البيانات | تعود المخرجات مباشرة للصوت | التطبيق يدقق ويحجب البيانات قبل العودة |
| التعقيد البرمجي | كود بسيط وسريع الإعداد | يتطلب معالجة أحداث ومزامنة حالات الجلسة |
| حالات الاستخدام المثالية | الدعم الفني العام والبحث السريع | الوكلاء المؤسسيون والمعاملات المالية وMCP |
مسار معالجة النظام
يوضح المخطط التالي تدفق التفاعل بين المتحدث، والواجهة الصوتية ثنائية الاتجاه، وناقل التفويض، والأنظمة الخلفية:
يتحدث المستخدم عبر اتصال متدفق ثنائي الاتجاه بالكامل. يعالج نموذج GPT-Live-1 الإطارات الصوتية الواردة، ويجري تقييماً صوتياً ولغوياً مستمراً، ويولد الصوت الصادر بالتزامن ودون قيود تبادل الأدوار التقليدية.
يقرر النموذج أن طلب المستخدم يتطلب استرجاع بيانات أو تشغيل أداة. يولد النموذج رداً شفهياً تفاعلياً يحافظ على طبيعية الحوار وانسيابيته، ويطلق بالتزامن حدث تفويض غير متزامن عبر ناقل الأحداث.
توجه أوبن إيه آي الطلب إلى نموذج GPT-5.6 Terra، وتنفذ الأدوات المسجلة، ثم تبث النتائج المهيكلة فوراً إلى الواجهة الصوتية.
يلتقط خادم المطور بيانات التفويض، وينفذ منظومات الوكلاء الخاصة، ويدقق البيانات الحساسة، ثم يحقن النتيجة المؤكدة في الجلسة.
تدخل النتائج المؤكدة إلى سياق المحادثة المباشر. يصيغ GPT-Live-1 الإجابة صوتياً بنبرة طبيعية ودون فترات صمت مصطنعة أو فقدان لحالة الحوار.
التطبيق البرمجي: تكوين الجلسة وفصل التعليمات
يتطلب إعداد جلسة GPT-Live-1 تحديد تعليمات المحادثة وتعليمات التفويض عند إنشاء الجلسة. وخلافاً للممارسات القديمة التي كانت تدمج قواعد العمل المعقدة، ومخططات JSON، والنبرة الصوتية في رسالة نظام واحدة ضخمة، يفرض GPT-Live-1 فصلاً صارماً في صياغة الأوامر.
يجب أن تبقى تعليمات الواجهة الصوتية (session.instructions) موجزة ومركزة حصرياً على أسلوب الكلام، وسرعة النبرة، وشروط استدعاء التفويض. أما تعليمات النموذج الخلفي (delegation.responses.instructions)، فهي المكان المناسب لقواعد العمل الدقيقة، وشروط الأذونات، وتنسيقات الاستجابة المطلوبة.
يوضح المثال التالي بلغة بايثون كيفية إنشاء جلسة تفويض Responses مُدارة مع ضبط أولوية التنفيذ:
from openai import OpenAI
from openai.types.live.session_config_param import SessionConfigParam

client = OpenAI()

# إعداد معلمات الجلسة مع التفويض المنفصل
session_config: SessionConfigParam = {
    "model": "gpt-live-1",
    "modalities": ["audio", "text"],
    "instructions": (
        "أنت مساعد دعم هندسي للبنية التحتية السحابية. "
        "اجعل الإجابات الشفهية موجزة ومباشرة ومريحة. "
        "عندما يطلب المستخدم تشخيصاً لعنقود الخوادم، فوض الطلب فوراً "
        "للخدمة الخلفية وأكد للمتحدث استلام طلبك شفهياً وبشكل طبيعي."
    ),
    "delegation": {
        "type": "responses",
        "responses": {
            "model": "gpt-5.6-terra",
            "service_tier": "priority",
            "instructions": (
                "استعلم عن حالة عناقيد كوبرنيتيس وقواعد القياس عن بعد. "
                "تحقق من سلامة الخدمات قبل إعادة الحالة، وأرجع ملخصاً تقنياً "
                "مؤكداً يحتوي أرقام العقد وأكواد الأخطاء بدقة."
            ),
            "tools": [
                {
                    "type": "function",
                    "name": "get_cluster_telemetry",
                    "description": "جلب مقاييس الذاكرة والمعالجات وحالة العناقيد في الوقت الفعلي",
                    "parameters": {
                        "type": "object",
                        "properties": {
                            "cluster_id": {"type": "string"},
                            "namespace": {"type": "string"},
                        },
                        "required": ["cluster_id"],
                    },
                }
            ],
            "tool_choice": "auto",
            "parallel_tool_calls": True,
        },
    },
}

# إنشاء الجلسة عبر نقطة نهاية v1/live/sessions
session = client.live.sessions.create(**session_config)
print(f"تم إنشاء الجلسة: {session.id}، الحالة: {session.status}")
بروتوكولات النقل وقنوات التحكم الجانبية
تواجه التطبيقات الصوتية في الإنتاج متطلبات شبكية مختلفة بحسب بيئة التشغيل:
- تدفقات WebRTC: لمتصفحات الويب وتطبيقات الهواتف، يُنقل الصوت عبر مسارات RTP المخصصة، بينما تُنقل إشارات التحكم والتفريغ النصي عبر قنوات بيانات WebRTC المتزامنة. يقلل هذا استهلاك معالج العميل ويزيل أعباء تأطير حزم WebSockets.
- بروتوكول WebSockets الأساسي: للخوادم التي تعالج دفقات الصوت الخام (PCM)، يستقبل المقبس الأساسي دفقات base64 عبر الحدث
session.input_audio.append، ويبث المقاطع الناتجة عبرsession.output_audio.delta. - القنوات الجانبية (Sideband WebSockets): تعد هذه الميزة من أقوى إضافات الواجهة الجديدة. عندما يتصل صوت العميل مباشرة بخوادم أوبن إيه آي عبر WebRTC لتقليل زمن الاستجابة، يستطيع خادم المطور الارتباط بالجلسة ذاتها عبر مقبس جانبي آمن. يتلقى الخادم تحديثات النصوص، ويراقب استدعاء الأدوات، ويطبق سياسات الحماية دون الحاجة لإعادة تشفير دفقات الصوت أو تأخيرها.
- ربط الاتصالات الهاتفية (SIP): يتيح التكامل المباشر مع خطوط SIP لشركات الاتصالات ومزودي الخدمات السحابية (مثل Twilio و Telnyx) تحويل المكالمات الهاتفية مباشرة إلى جلسات GPT-Live-1 دون الحاجة لخوادم وسيطة لتحويل الصوت إلى WebRTC.
الانتقال من واجهة الوقت الفعلي القديمة: تغييرات الأحداث الجذرية
تتطلب ترقية التطبيقات القائمة على واجهة الوقت الفعلي القديمة (v1/realtime)، بالتوازي مع التحولات الأوسع في منصة النماذج والتي وثقناها في دليل الهجرة وإيقاف الخدمات في أوبن إيه آي، تعديل معالجات الأحداث بصورة جوهرية. وبسبب إلغاء تقسيم الأدوار التقليدي، طرأت التغييرات التالية:
مقارنة الأحداث بين Realtime القديمة و GPT-Live-1
| المرحلة التشغيلية | نمط أحداث Realtime القديم | نمط أحداث GPT-Live-1 الجديد |
|---|---|---|
| إرسال الصوت | input_audio_buffer.append | session.input_audio.append مع دفقات base64 خام |
| استقبال دفقات الصوت | response.output_audio.delta | session.output_audio.delta تبث بتسلسل زمني |
| اعتماد الدور الصوتي | إرسال يدوي أو كشف صمت VAD | دفق مستمر ونظام التحكيم يحدد الكلام ديناميكياً |
| اكتمال الكلام | response.output_audio.done أو response.done | لا يوجد حدث اكتمال شفهي، العميل يراقب مخزنه |
| نصوص الإدخال | conversation.item.input_audio_transcription | تضاف نصوص session.input_transcript.delta مستقلاً |
| استدعاء الأدوات | في المستوى الأعلى response.output_item.done | ضمن تفويض مغلف في response.output_item.done الداخلي |
| إرجاع النتائج | conversation.item.create | استخدام response.item.create مع response.create |
ويعد غياب حدث يحدد نهاية الرد الصوتي تغييراً جوهرياً يستوجب الانتباه. في نظام ثنائي الاتجاه، قد يستمع النموذج ويتحدث في اللحظة نفسها. وبالتالي لا يمكن للخادم الافتراض بأن المساعد قد انتهى من التحدث لمجرد أن مخزن التوليد لديه قد فرغ، لأن مخزن الصوت لدى العميل قد يكون لا يزال يشغل ثانية إضافية من الصوت. يجب على المطورين قياس حالة التحدث بناءً على حالة تشغيل الصوت في جهاز العميل الفعلي.
القيود التقنية والتحديات الهندسية القائمة
رغم القفزة النوعية التي يحققها GPT-Live-1، يجب على الفرق الهندسية أخذ القيود التالية في الحسبان قبل الاعتماد الكامل عليه في الإنتاج:
- غياب الإشارة الصوتية الخام في التفويض: عندما يطلق GPT-Live-1 تفويضاً للعميل، يحمل الحدث
session.delegation.createdبيانات نصية ووصفية فقط، ولا يحمل الترددات الصوتية الخام. فإذا كان تطبيقك يعتمد على إشارات صوتية فيزيائية (مثل كشف نغمات آلات الرد الآلي، أو نغمات أزرار الهاتف DTMF، أو مصنفات المشاعر القائمة على النبرة)، فلن يتمكن الوكيل المفوض من فحصها. يجب في هذه الحالة تشغيل مسار تحليل صوتي موازٍ بجانب الجلسة. - حدود الوسائط الصارمة: لا تقبل الواجهة الصوتية صوراً أو مستندات أو فيديو مباشرة. إذا قال المستخدم “انظر إلى هذا الخطأ الظاهر في شاشتي”، لا يستطيع النموذج الصوتي قراءة الصورة. يجب على تطبيق العميل التقاط الشاشة ورفعها عبر واجهة الملفات أو القناة الجانبية، ثم حقن الوصف البصري في سياق التفويض الخلفي.
- ثبات الأصوات والتوقيع الرقمي: لمنع انتحال الشخصيات ومخاطر التزييف الصوتي، لا يدعم النموذج استنساخ أصوات عشوائية، ويلتزم المطور بقائمة أصوات رسمية معتمدة ومجهزة مسبقاً. كما تتضمن جميع الأصوات المولدة علامة مائية صوتية رقمية مشفرة عبر تقنية SynthID لضمان التحقق من مصدر الصوت.
- زمن المصافحة الأولى للاتصال: في حين أن استجابة الحوار تحت-الثانية ممتازة بعد استقرار الاتصال، فإن بدء الجلسة عبر WebRTC يتطلب تفاوض SDP ومصادقة سحابية أولية. يُنصح في التطبيقات الهاتفية بتهيئة الجلسات مسبقاً قبل توجيه المكالمات لتفادي اقتطاع الكلمات الأولى.
خطة عمل تنفيذية للمطورين
- تدقيق مسارات العمل الصوتية الحالية: إذا كانت بنيتك الحالية تعتمد على كشف الصمت بمهلات تتجاوز 400 مللي ثانية، قيم الترقية إلى GPT-Live-1 للتخلص من فترات التردد وتصادم الكلام.
- فصل صياغة الأوامر: جرد التعليمات الصوتية من مخططات JSON وقواعد البيانات الثقيلة. خصص
session.instructionsللإيقاع والأسلوب الصوتي العام، وانقل كافة منطق الأعمال إلىdelegation.responses.instructions. - اختيار نمط التفويض وفق متطلبات الأمان: استخدم تفويض Responses للاستعلامات العامة والبحث في الويب حيث تكفي أدوات أوبن إيه آي. واستخدم تفويض العميل المستقل عندما تتطلب المعالجة بيانات مشفرة، أو أدوات مبنية على بروتوكول MCP، أو مسارات موافقة متعددة المراحل.
- تتبع تشغيل الصوت من جانب العميل: حدث مكتبات تشغيل الصوت في تطبيقاتك لتعتمد المؤشرات البصرية (مثل أمواج التحدث) على حالة التشغيل الفعلية لمخازن WebRTC في جهاز المستخدم، بدلاً من إشارات الخادم.
- إعادة حساب تكاليف التشغيل: حدث دراسات الجدوى المالية بناءً على تسعير 0.05 دولار للدقيقة (3.00 دولارات للساعة). وبفضل الحساب بالثانية، فإن المكالمات القصيرة (مثل مكالمات التحقق التي تستغرق 45 ثانية) ستكلف نحو 0.0375 دولار كرسوم جلسة إضافة لرموز الاستدلال الخلفي، وهو ما يوفر مبالغ ملحوظة مقارنة بالأنظمة التي تقرب الفواتير للدقيقة الكاملة.