DeepSeek تطلق V4.1-Flash: أول معمارية Encoder-Decoder سببية في الميدان، رؤية أصلية، وكاشف KV أصغر بـ4 مرات
DeepSeek تطلق V4.1-Flash: أول معمارية Encoder-Decoder سببية في الميدان، رؤية أصلية، وكاشف KV أصغر بـ4 مرات
بعد أسابيع من التجربة البصرية التي غطيناها في إطلاق V4-Flash-Vision-Exp التجريبي، أطلقت DeepSeek اليوم النموذج الكامل: DeepSeek-V4.1-Flash، أول نموذج في عائلة معمارية جديدة كلياً، بتفعيل بيتي غير متماثل، ورؤية مدمجة منذ التدريب، وكاشف KV انكمش إلى ربع الجيل السابق. الإعلان ليس مجرد إصدار نموذج: معه خطة إحالة كاملة ترسل عملاء V4-Pro إلى النموذج الجديد، وخفض سعر واجهة يضاعف الضغط على المنافسين، وأوزان مفتوحة بترخيص MIT.
ما حدث
الإعلان على سجل التغييرات الرسمي وصفحة الأخبار يحدد الحقائق التالية:
- النموذج متاح على واجهة DeepSeek بالاسم
deepseek-flashبدعم متعدد الوسائط أصلي. النموذجان السابقان V4-Flash و V4-Flash-Vision-Exp تقاعدا، والأسماء القديمة توجَّه مؤقتاً إلى V4.1-Flash للتوافق. - بعد اختبارات موسعة، تقول DeepSeek إن V4.1-Flash تجاوز V4-Pro في الأداء والتكلفة والسرعة والزمن الكلي، ولهذا تُقاعد V4-Pro تدريجياً: ابتداءً من 04:00 بتوقيت UTC يوم 14 سبتمبر 2026، كل طلبات
deepseek-v4-proستوجَّه إلى V4.1-Flash وتُفوتر بسعره، حتى صدور V4.1-Pro مستقبلاً. - الأسعار الجديدة سارية من 04:00 UTC يوم 10 سبتمبر، مع استمرار نموذج الذروة/خارج الذروة.
- الأوزان منشورة على Hugging Face بترخيص MIT، مع تقرير تقني كامل.
المعمارية الجديدة: لماذا 8B للإدخال و16B للإخراج
هنا جوهر الخبر. V4.1-Flash نموذج MoE بـ552 مليار معامل، لكنه مبني على معمارية Causal Encoder-Decoder: محول من 40 طبقة مقسم إلى مُشفِّر سببي من 20 طبقة يليه مُفكِّك من 20 طبقة. الفارق الجوهري أن الكاشف العالمي لذاكرة KV في المفكك يُسقط من الحالات الخفية النهائية للمشفر، بدل أن تحسبها كل طبقة فك عن حالتها الخاصة.
النتيجة العملية: التفعيل غير متماثل، 8 مليارات معامل فقط نشطة لكل رمز أثناء المعالجة المسبقة (قراءة سياقك)، و16 ملياراً أثناء التوليد. لأحمال العمل الوكيلية ثقيلة الإدخال، حيث تلتهم قراءة السياق معظم التكلفة والزمن، هذا تقسيم مباشر لمصدر الفاتورة الأكبر.
المعاملات التفصيلية من بطاقة النموذج: خبير مشترك واحد و384 خبيراً موجهاً في كل طبقة MoE مع تفعيل 6 خبراء لكل رمز، وذاكرة شرطية باسم Engram بحجم 196 مليار معامل تُوصل ببحث قائم على الرموز، وفك ترميز تخميني باسم DSpark بتوليد مسودة شبه ذاتي الترتيب.
كاشف KV: من 3,514 إلى 890 بايت للرمز
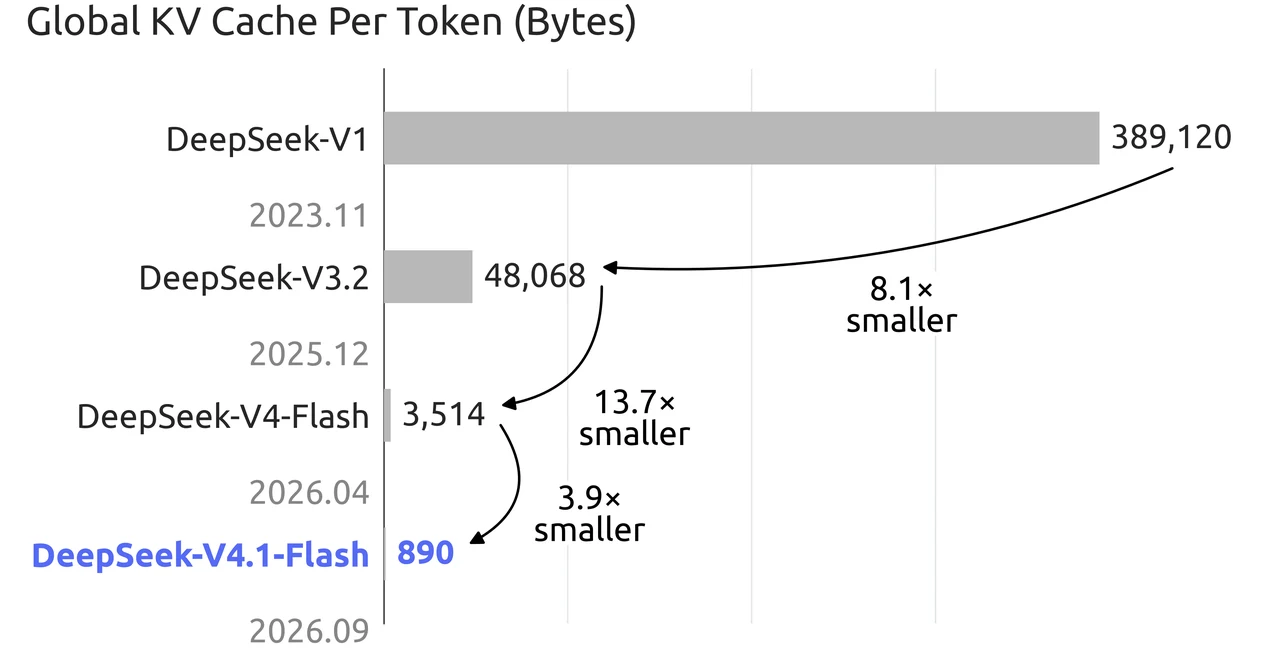
الرقم الذي يستوقف كل من يشغّل نماذج بسياق طويل: الكاشف العالمي لذاكرة KV انخفض إلى 890 بايت لكل رمز، أي ربع ما كان عليه في V4-Flash (3,514 بايت)، وثمن عما كان في DeepSeek-V1 تقريباً (389,120 بايت، أي 437 مرة).
ثلاثة عناصر تفعل ذلك معاً: تخزين KV الرئيسي بدقة FP4 بصيغة E2M1 مع مقياس E4M3 واحد لكل 16 قناة، ومعمارية انتباه متناثر من الجيل الثاني CSA2 تُسند لكل طبقة واحدة من ثلاثة أنماط ثابتة (كامل، إعادة فهرسة، إعادة استخدام) لتقاسم الكاشف والفهارس بين الطبقات، وأخيراً أسلوب SWA Bounded Replay يعيد بناء حالات نافذة الانتباه المنزلق بإعادة تشغيل آخر عدد محدود من الرموز بدل تخزينها على القرص، فتنكمش الحصة الدائمة من الكاشف إلى نحو الثمن مقارنة بالجيل السابق.
أثر ذلك على المستخدم النهائي مباشر وليس لمهندسي مراكز البيانات فقط؛ لأن رسوم إصابة الكاشف (Cache Hit) تشكل حصة كبيرة من فاتورة الوكلاء، وضغط الكاشف يعني تكلفة إصابة أرخص، ويعني أيضاً نشراً محلياً أقل عطشاً للذاكرة.
الأرقام: أين يتقدم فعلاً وأين يتأخر
جدول الأداء الرسمي (جهود استدلال قصوى) يقارن النموذج مع Opus-5.0 و GPT-5.6 Sol و Kimi-K3 و GLM-5.3 ومع شقيقيه السابقين. القراءة الأمينة تقول:
يتصدر الميدان:
- Terminal-Bench 2.1: 90.6، الأعلى حتى فوق Opus 5 (89.1) و GPT-5.6 Sol (88.8).
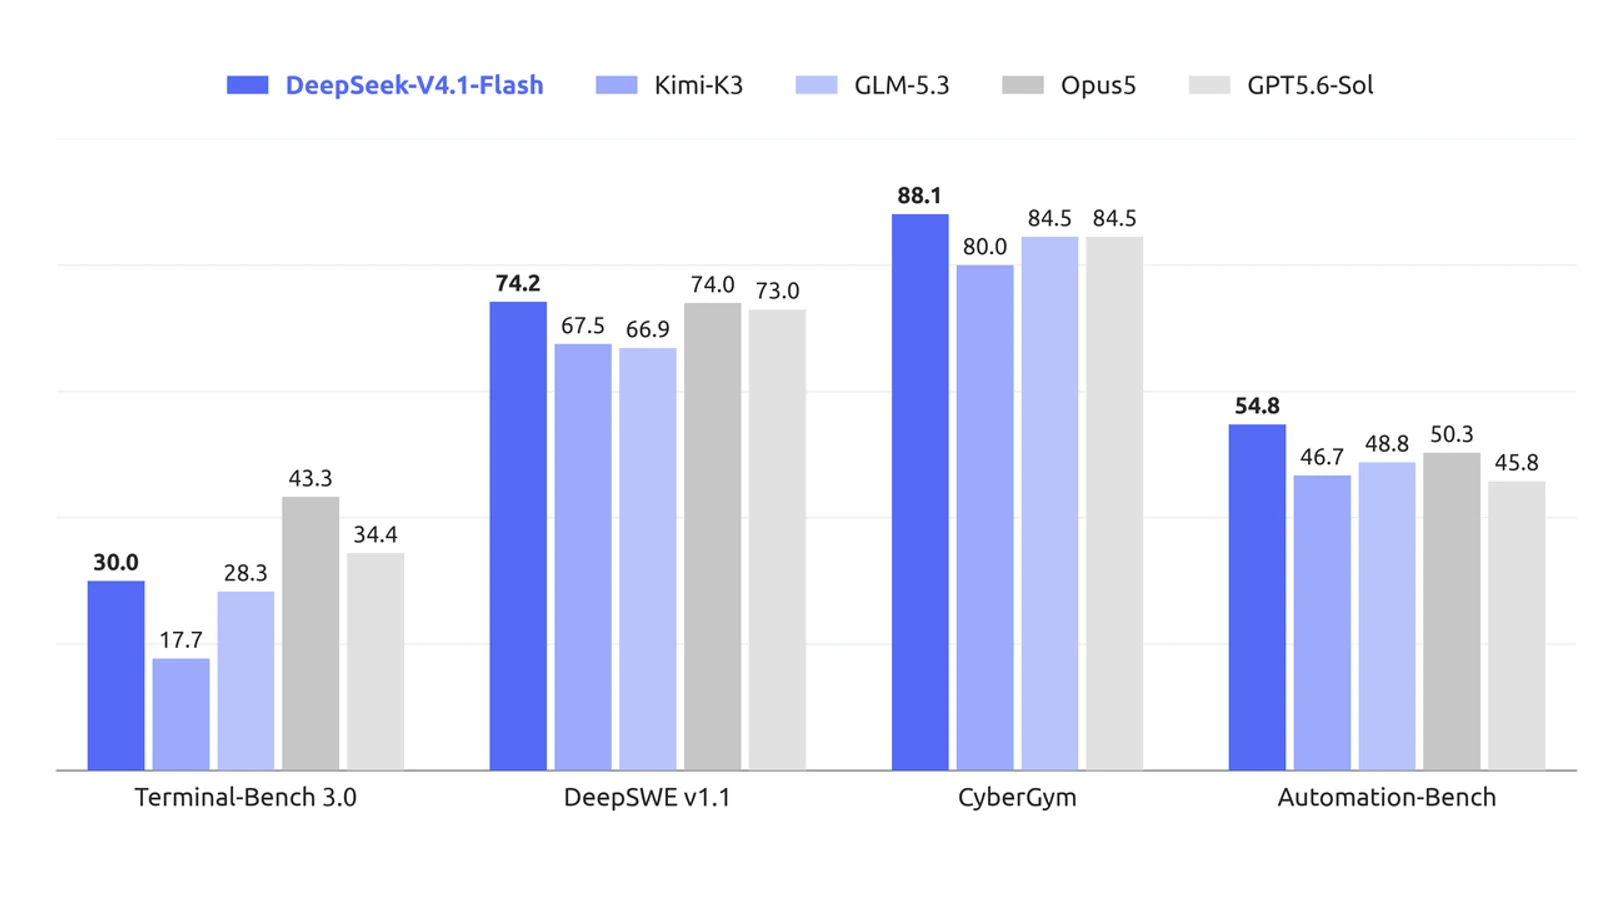
- DeepSWE v1.1: 74.2، متقدماً بفارق ضئيل على Opus 5 (74.0) و Sol (73.0).
- CyberGym: 88.1 مقابل 84.5 لكل من Opus 5 و Sol و GLM-5.3.
- Automation-Bench: 54.8 مقابل 50.3 لـ Opus 5.
- Agent’s Last Exam: 31.8، الأعلى في الجدول كله.
- Codeforces: تقييم 3471، وهو الأعلى المعلن بين النماذج المفتوحة والأغلق في القائمة.
- GPQA Diamond: 90.9، قريب جداً من الصدارة (Opus 93.4، Sol 94.1).
يتأخر عن الصدارة:
- HLE: 36.8 (و39.1 على المجموعة النصية فقط) مقابل 56.3 لـ Opus 5 و44.5 لـ Sol. فجوة واضحة في أصعب اختبار معرفي.
- Terminal-Bench 3.0 و 4.0: 30.0 و31.2 مقابل 43.3 و51.8 لـ Opus 5. الأجيال الأحدث من Terminal-Bench تفصل الفئة العليا عن البقية، والنموذج في الفئة الثانية مع Sol (34.4 و39.9).
- مهام الرؤية بالأدوات: Chartography 78.9 و BabyVision 89.6 و ZeroBench 49.0، كلها خلف Opus 5 مباشرة وأمام باقي القائمة غالباً.
الاستنتاج الصادق: هذا نموذج “فلاش” بأسعار فلاش يتقاطع مع العرائس الحدودية في معايير الوكلاء العملية، ويبقى خلفها في أعمق مهام الاستدلال المعرفي. شركة الإعلان نفسها وضعت الجدول الكامل بلا حجب، وهذه نقطة تُحسب لها.
الأسعار وخطة قتل V4-Pro
جدول التسعير الجديد لكل مليون رمز (ذروة / خارج الذروة، وخارج الذروة يعادل نصف سعر الذروة):
- المدخلات مع إصابة كاشف: $0.006 / $0.003
- المدخلات بدون كاشف: $0.30 / $0.15
- المخرجات: $1.20 / $0.60
- حد التزامن: 2500 طلب، مقابل 500 لـ V4-Pro
ساعات الذروة هي 01:00 إلى 04:00 و06:00 إلى 10:00 UTC من الاثنين إلى الجمعة، وكل الساعات الأخرى خارج الذروة. للمقارنة، V4-Pro الحالي تُفوتر $1.32/$0.66 للمدخلات بدون كاشف و$3.96/$1.98 للمخرجات. أي أن الانتقال القسري القادم في 14 سبتمبر يخفض فاتورة عملاء deepseek-v4-pro إلى الثمن تقريباً مع تحسن مُعلن في الأداء، وتخفيض حد التزامن من 500 إلى 2500 هو في مصلحة العميل أيضاً.
ضع الأسعار جنباً إلى جنب مع GLM-5.3-Flash الذي غطيناه سابقاً بـ$0.075/$0.25، وسترى حرب الطبقة الاقتصادية في النماذج الحدودية تشتد من جهتين: DeepSeek يجلب قدرة قريبة من القمة بسعر أقل، والبقية يجيبون بأسعار قريبة من الصفر.
الأوزان المفتوحة وحقيقة التشغيل المحلي
الأوزان على Hugging Face بترخيص MIT صريح، مع التقرير التقني الكامل وأدلة استدلال وتحويل للأوزان داخل المستودع، وإعلان صريح بتعاون مع مجتمع المصدر المفتوح على دعم الاستدلال، مع جملة لافتة: “تخطط لنشر واسع بـ2000 كارت GPU وعنقود تخزين؟ لنتحدث”.
لكن حديث النشر المحلي في ثريد r/LocalLLaMA أول يوم كان واقعياً لا حماسياً. النموذج 552 مليار معامل، وإليها تُضاف ذاكرة Engram بحوالي 196 مليار معامل إضافية. تقديرات المجرّبين المتفق عليها في الثريد: نحو 306 جيجابايت للأوزان نفسها (طبقات MoE بأربعة بتات أصلاً فلا اختصار تُذكر من التكميم)، ونحو 204 جيجابايت لجداول Engram التي يمكن بثها من القرص مقابل عقوبة زمن. النتيجة العملية: ثلاثة أجهزة DGX Spark هي الحد الأدنى، وأربعة تجعل التجربة مريحة، ومن يريد زمن وصول أول رمز منخفضاً مع الإبقاء على الذاكرة الشرطية في الرام يحتاج نحو 500 جيجابايت. خلاصة أحد المعلقين تختصر المشهد: “فكرتهم عن كلمة صغير هي مبنى مليء بكرت GPU”.
وهنا أخطر ملاحظة نقدية في الثريد، وقد صيغت بدقة: مع جودة بهذا المستوى وسعر بهذا الانخفاض، تنهار الحجة الاقتصادية للاستضافة المحلية عند معظم الناس. الاستضافة المحلية تبقى لمن يملك قيود خصوصية أو سيطرة أو تكلفة شبكة، لا لمن يبحث عن السعر.
اختبارات المستخدمين الأولى
الثريد (أكثر من 50 تعليقاً في الساعات الأولى) يدور حول ثلاثة محاور، وكلها تهم مطور الوكلاء:
- فهم المعمارية: النقاش الأكثر جودة دار حول كون CED “مشفراً” بالمعنى التقليدي. المعلقون الذين قرأوا التوثيق صححوا الانطباع الأول: المشفر ليس ثنائي الاتجاه، بل النصف الأول من الطبقات يبني كاشف الذاكرة الأساسي والنصف العلوي يعيد استخدامه، فيتخطى نحو نصف الحسابات الثقيلة. أحدهم ربط ذلك بورقة قديمة من Microsoft وجدت أن محتوى KV يكاد لا يتغير بعد منتصف الطبقات. النقاش خلاصته للعارِم: توقع تسارع معالجة السياق أكثر من تسارع التوليد.
- جدول المقارنة نفسه: ملاحظة متكررة أن التسمية “فلاش” لم تعد تعبر عن الحجم (النموذج أكبر بقرابة الضعف من جيله السابق)، وأن المنافس الحقيقي على الورق في فئته هو GLM-5.3-Flash بنصف الحجم، والفارق بينهما في الاستخدام الفعلي ما يزال يحتاج قياسات مستقلة.
- الدعم البيئي: وصفات تشغيل على vLLM لأربع وحدات DGX Spark نشرها المجرّبون خلال ساعات، وأمل معلن في دعم llama.cpp، وتساؤلات جدية إن كانت Qwen ستتبنى التفعيل غير المتماثل وتقنية ضغط الكاشف. الشراكة المعلنة مع OpenCode و WorkBuddy تعني أن الوكلاء الشعبيين سيرى النموذج من اليوم الأول.
انتبه للحدود: هذه انطباعات يوم الإطلاق، لا تقييمات بعد أسابيع استخدام. لا توجد بعد قياسات مستقلة للأداء المعلن، وكل أرقام الجداول أعلاه مصدرها DeepSeek نفسها بإطار تقييمها الخاص، وإن كانت البطاقة توثق الأجهزة والمعاملات بالتفصيل وتنشر أدوات إعادة الإنتاج.
للمطور: ماذا تفعل الآن
- على الواجهة: بدّل اسم النموذج إلى
deepseek-flash. إن كنت علىdeepseek-v4-flashأوdeepseek-v4-flash-vision-expفأنت فعلياً تستخدم V4.1-Flash الآن، والاسمان القديمان مؤقتان. - على V4-Pro: خطة 14 سبتمبر ستخفض فاتورتك تلقائياً لكنها تغير سلوك النموذج. اختبر أحمالك الحساسة قبل الموعد، وثبّت الإصدار في إعداداتك إن كانت النتائج حرجة.
- لوكالات العمل: ذاكرة الكاشف الأصغر تجعل الوكلاء طواه السياق أرخص بنيوياً. أعد حساب ميزانيتك مع أسعار الإصابة الجديدة، وحرّك الأحمال المرنة إلى خارج الذروة (كل الساعات عدا نوافذ الذروة المذكورة).
- للرؤية: الدعم أصلي وبدون لاحقة تجريبية هذه المرة. صور المستندات والمخططات واللوحات تدخل مباشرة في سياق المليون رمز.
- للتشغيل المحلي: احسب قبل التنزيل: نحو 306 جيجابايت أوزان تُضاف إليها إستراتيجية واضحة لذاكرة Engram. لا تجرّب بجهاز أقل من ثلاث وحدات Spark أو ما يعادلها من الرام الموحد.
حدود يجب ذكرها
كل الأرقام المرجعية أعلاه من DeepSeek ذاتها، بحرص موثق على تفاصيل الاختبار (درجة الجهد القصوى، حرارة 1.0، أطر محددة لكل معيار)، لكنها تظل أرقام بائع حتى تُستنسخ مستقلاً. بطاقة النموذج تتيح إعادة إنتاج DeepSWE بخطوات مفصلة، وهذا يسهّل التحقق على من يريد. فجوة HLE عن Opus 5 حقيقية وواسعة، وتقاعد V4-Pro قبل صدور V4.1-Pro يترك فجوة مؤقتة في قمة تشكيلة الشركة لم يعوضها أحد بعد. وأخيراً، عمليات الترحيل القسرية بين أسماء النماذج مريحة للتوافق لكنها تطمس الفروقات السلوكية بين الأجيال، فلا تفترض أن نتائج اختباراتك القديمة على deepseek-v4-flash ما تزال صالحة.